Moteur de recherche IA interne pour documents et contrats d'entreprise : comment choisir sans se tromper
La réponse courte
Un moteur de recherche IA interne, c'est un outil qui lit vos documents (contrats, devis, comptes rendus, procédures) et répond à une question posée en français, idéalement en citant le document et la page d'où vient l'information. Concrètement : « Quel est le préavis de résiliation du contrat Lefevre ? » → la clause, le nom du fichier, le numéro de page.
Ce qu'il ne fait pas : il ne garantit pas que le document qu'il a lu est la bonne version, il ne remplace pas une relecture juridique, et il ne devine rien sur un PDF scanné illisible. C'est un outil de retrouvage, pas un juriste.
Et il y a une question préalable, honnête : si vos contrats tiennent dans un seul dossier bien nommé, une arborescence propre et la recherche de Windows ou de SharePoint règlent déjà une bonne partie du problème. L'IA devient intéressante quand l'information est dispersée (serveur de fichiers, SharePoint, Outlook, GED, scans) et quand la question porte sur le sens d'une clause, pas sur un nom de fichier.
Transparence : cet article est publié par MistralJS, qui vend des intégrations IA aux PME. Nous décrivons donc aussi des solutions que nous ne vendons pas, et nous signalons explicitement, plus bas, où se situe notre intérêt commercial.
Le principe, sans jargon
Trois niveaux, à ne pas confondre :
- Recherche par mots-clés : l'outil cherche la chaîne de caractères exacte. Si le contrat dit « dénonciation » et que vous tapez « résiliation », vous ne trouvez rien.
- Recherche sémantique : l'outil comprend que « dénonciation », « résiliation » et « fin de contrat » parlent de la même chose. L'intégrateur Coexya décrit ainsi ses propres chaînes d'indexation, qui intègrent des briques de traitement automatique du langage naturel (NLP/TAL), de classification par machine learning et de détection de similitudes ; il parle alors d'insight engines, capables de recommander des contenus au-delà d'une simple requête textuelle (Coexya).
- RAG (Retrieval-Augmented Generation) : l'outil retrouve les passages pertinents dans vos données, puis un modèle de langage rédige une réponse à partir de ces passages. Dans la documentation de LlamaIndex, un pipeline RAG comporte cinq étapes : chargement des données depuis leurs sources, indexation (le plus souvent sous forme d'embeddings, des représentations numériques du sens, stockées dans une base vectorielle), stockage de l'index, interrogation, puis évaluation de la qualité des réponses (LlamaIndex). Les documents y sont découpés en « nœuds », c'est-à-dire en fragments d'un document source, porteurs de métadonnées qui les relient au document d'origine (LlamaIndex).
C'est le troisième niveau qui change le quotidien : vous ne recevez plus une liste de dix fichiers à ouvrir, mais une réponse que vous pouvez vérifier — à condition d'exiger la citation de la source.
Les cinq questions qu'une PME pose vraiment à ses contrats
- Quel est le préavis de résiliation, et sous quelle forme (LRAR, email) ?
- Ce contrat est-il en reconduction tacite, et à quelle date tombe la prochaine échéance ?
- Quelles pénalités sommes-nous censés appliquer (ou subir) en cas de retard ?
- Avons-nous signé un engagement de volume minimum ?
- Existe-t-il une clause de révision de prix, indexée sur quoi ?
Si ces cinq questions vous coûtent une fouille pénible à chaque fois, vous avez un cas d'usage. Notez-les : elles serviront au protocole de test plus bas.
Les trois familles de solutions
1. Les outils « à fichiers » : notebooks et espaces de travail
On y dépose des documents, on pose des questions dessus. Google indique renommer NotebookLM en Gemini Notebook, produit qui « reste un produit autonome axé sur la recherche » (aide administrateur Google Workspace). L'outil accepte notamment des PDF, des documents Docs et Slides, du texte copié, des URL publiques, des fichiers audio et images (Google Cloud). Deux points comptent pour une PME :
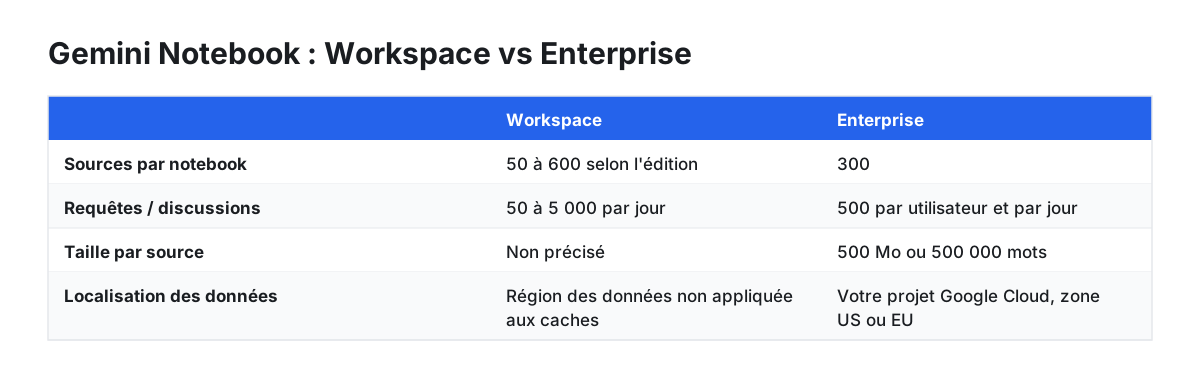
- Les volumes sont plafonnés. Côté Workspace, le nombre de sources par notebook va de 50 à 600 selon l'édition, et les discussions de 50 à 5 000 par jour (Google Workspace). La version Gemini Notebook Enterprise est documentée à 300 sources par notebook, 500 notebooks par utilisateur et 500 requêtes par utilisateur et par jour, avec une limite de 500 Mo ou 500 000 mots par source (documentation Google Cloud). Un fonds de plusieurs milliers de contrats ne rentre donc pas dans un notebook.
- Les droits d'accès dépendent de l'environnement. Dans Workspace, les fichiers Drive ajoutés sont synchronisés automatiquement et les paramètres de partage existants s'appliquent : seul un utilisateur ayant au moins un accès en lecture au fichier d'origine peut l'utiliser comme source — mais Google précise aussi que les paramètres de région des données de l'organisation ne s'appliquent pas aux données traitées et mises en cache par Gemini Notebook (Google Workspace). Sur l'édition Enterprise, Google indique que les données sources sont stockées dans votre projet Google Cloud, en zone multirégionale US ou EU, qu'aucun autre service Google Cloud ne peut y accéder, avec authentification via Cloud Identity ou un fournisseur d'identité tiers (Microsoft Entra ID, Okta, Ping, OIDC ou SAML 2.0) et des rôles IAM dédiés (Google Cloud).
Verdict : adapté pour tester le principe sur vos quelques dizaines de contrats les plus utilisés. Insuffisant dès que le fonds à interroger dépasse la limite de sources de votre édition (de 50 à 600 par notebook côté Workspace, 300 côté Enterprise). À noter, pour les sources importées (et non pour les fichiers Drive synchronisés dans Workspace), Google documente un fonctionnement sur copie statique du document.
2. Les moteurs d'entreprise et leurs intégrateurs
On parle ici de plateformes comme Sinequa, Elasticsearch, Algolia ou Google Cloud Search. Sinequa est présenté par l'intégrateur Coexya comme offrant un large catalogue de connecteurs vers plus de 150 types de sources de données (Coexya). Ces solutions visent à indexer et croiser des données issues de sources hétérogènes (GED, ERP, cloud, sites web) derrière un point d'accès unique (Coexya). Coexya indique s'appuyer sur ces technologies et affiche comme références des grands comptes et des institutions publiques — TotalEnergies, Groupama, Conseil d'État, Unicancer, Centre Pompidou (Coexya).
3. Le développement interne ou sur mesure
Assembler soi-même un pipeline RAG est techniquement accessible : des frameworks documentés comme LlamaIndex fournissent les briques (connecteurs de données, index, retrievers, synthétiseurs de réponse) et proposent des centaines de connecteurs pour charger les données (LlamaIndex).
Mais l'éditeur LightOn — qui vend des API de recherche et a donc intérêt à défendre l'achat plutôt que le fait-maison, à lire comme tel — décrit le décalage entre prototype et production : selon lui, une première démonstration peut fonctionner en quelques semaines, mais un système de production exige « un travail continu sur le traitement des documents, la qualité de la recherche, les permissions, la sécurité et la maintenance » (LightOn). LightOn ajoute qu'un système performant sur les documents RH « peut avoir du mal » quand la finance introduit factures, tableurs et contrats, et que ces systèmes reposent souvent sur un ou deux ingénieurs : s'ils partent, la connaissance nécessaire à la maintenance part avec eux (LightOn).
Pour une PME sans informatique interne, cette option n'est donc pas le choix par défaut : c'est un choix conditionnel, à réserver aux cas où un outil standard ne couvre pas le besoin.
Grille d'évaluation en 7 critères
| Critère | Ce qu'il faut demander | Signal d'alerte |
|---|---|---|
| Connecteurs | Vers quelles sources exactement (SharePoint, serveur SMB, Outlook, GED métier) ? | « On exporte tout dans l'outil » |
| Droits d'accès | Les permissions existantes sont-elles reprises, utilisateur par utilisateur ? | Un index unique visible par tous |
| Citation à la page | Chaque réponse renvoie-t-elle au fichier et à la page ? | Réponse sans source cliquable |
| PDF scannés | L'OCR est-il inclus ? Testé sur vos pires scans ? | Démo uniquement sur des PDF natifs |
| Hébergement / RGPD | Où sont stockées et traitées les données, y compris les caches ? Vos documents servent-ils à entraîner des modèles ? | Réponse floue sur la localisation |
| Coût total sur 3 ans | Licences + intégration + reprise documentaire + évolutions | Prix affiché « par utilisateur » seul |
| Maintenance | Qui ajoute un nouveau format, une nouvelle source, qui surveille la qualité ? | « C'est livré, ça tourne » |
Sur le point « hébergement », les documentations fournisseurs donnent des réponses très différentes d'une offre à l'autre : Google écrit par exemple que, dans Workspace, les paramètres de région des données de l'organisation ne s'appliquent pas aux données mises en cache par Gemini Notebook, alors que sur l'édition Enterprise les données restent dans le projet Google Cloud du client (Google Workspace, Google Cloud). Exigez la réponse par écrit, offre par offre.
Note de contexte réglementaire, à cadrer avec votre conseil : dès lors que vos documents contiennent des données personnelles (salariés, clients, contacts), le choix du prestataire, la localisation du traitement et la réutilisation éventuelle des données pour l'entraînement de modèles relèvent de vos obligations habituelles en matière de protection des données. Cet article ne traite pas ce sujet en détail et ne constitue pas un conseil juridique.
Ce que l'IA ne règle pas
- Les réponses plausibles mais fausses. Un modèle mal contraint peut produire une réponse qui n'est pas fondée sur vos documents. Exigez la citation obligatoire et un « je ne trouve pas » explicite, puis vérifiez-le vous-même pendant le test.
- Les scans de mauvaise qualité. LightOn note que « les documents scannés ajoutent une difficulté supplémentaire » (LightOn). Testez sur vos pires fichiers, pas sur les plus propres.
- Les versions concurrentes. Trois PDF du même contrat, un avenant non classé : l'outil répondra sur celui qu'il trouve. Notez aussi que certains outils travaillent sur une copie statique du document importé : Google précise que Gemini Notebook crée une copie statique de la source au moment de l'import et s'appuie ensuite sur cette copie pour répondre (Google Cloud).
- La relecture humaine. Une réponse IA est une aide à la lecture et doit être vérifiée à la source avant toute décision. L'engagement reste au contrat signé.
Le protocole de test en 20 questions, avant de signer
C'est la partie que personne ne fait et qui évite les mauvaises surprises. Prenez vos documents, pas la démo du fournisseur. L'évaluation est d'ailleurs présentée comme une étape à part entière d'un pipeline RAG, destinée à mesurer objectivement l'exactitude, la fidélité et la rapidité des réponses (LlamaIndex).
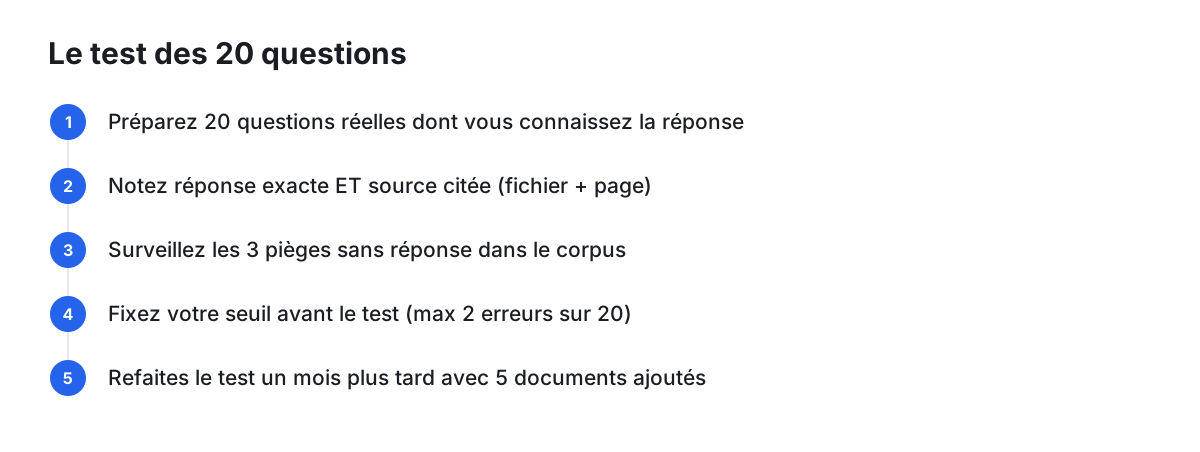
- Préparez 20 questions réelles dont vous connaissez déjà la réponse : 8 clauses factuelles (préavis, pénalité, date), 4 sur des contrats modifiés par avenant, 3 portant sur des documents scannés, 3 pièges dont la réponse n'existe pas dans le corpus, 2 nécessitant de croiser deux documents.
- Notez chaque réponse sur deux colonnes : réponse exacte (oui/non) et source correctement citée (fichier + page, oui/non). Une bonne réponse mal sourcée compte comme un échec : vous ne pourrez pas la vérifier en situation réelle.
- Surveillez les 3 pièges. Un outil qui produit une réponse affirmative là où l'information n'existe pas est disqualifiant, quel que soit son score global.
- Fixez votre seuil avant le test, pas après. Exemple hypothétique de règle interne, à calibrer selon vos enjeux : on ne déploie pas si plus de 2 réponses sur 20 sont fausses, ou si un seul des 3 pièges déclenche une réponse inventée.
- Refaites le test un mois plus tard avec 5 documents ajoutés entre-temps. C'est là qu'on voit la maintenance et la fraîcheur de l'index.
Ce protocole tient en une demi-journée, et il vous en apprendra plus qu'un comparatif générique.
Préparer ses documents : le vrai travail préalable
Avant même de choisir un outil : dédoublonnez, définissez une version de référence par contrat, rattachez les avenants au contrat principal, adoptez un nommage lisible (client_objet_année). Ce travail conditionne directement la qualité de l'indexation, puisque l'index se construit à partir des documents que vous lui donnez (LlamaIndex). Il améliore aussi la recherche classique : il n'est jamais perdu.
Quand un outil standard suffit — et quand il ne suffit plus
Dans beaucoup de PME, la bonne réponse n'est pas un projet. Une arborescence propre, la recherche native de Windows ou de SharePoint, et un outil à fichiers pour les questions de fond couvrent l'essentiel tant que le corpus reste sous les limites de sources de votre édition (Google Workspace).
Une intégration sur mesure ne devient une option qu'à trois conditions cumulées : l'information est dispersée entre plusieurs systèmes, les droits d'accès doivent être respectés finement, et les questions reviennent assez souvent pour justifier une maintenance dans la durée.
Transparence commerciale : MistralJS, éditeur de cet article, est une agence d'intégration IA pour PME à Marseille et en région PACA (MistralJS). Nous avons donc intérêt à ce que vous choisissiez le sur-mesure — raison de plus pour appliquer d'abord le test des 20 questions à une solution standard. Sur notre offre, nous indiquons connecter l'outil à vos documents là où ils sont (SharePoint, Drive, serveur interne) sans rien déplacer, avec citation systématique du document et de la page et respect de vos droits d'accès existants ; nous indiquons également que nos clients l'utilisent sur des fonds de 200 à 20 000 documents (MistralJS). Ce sont des déclarations de notre part, à vérifier sur vos propres documents. Le détail est sur notre page recherche dans les documents internes.
Arbre de décision en une page
- Quelques dizaines de documents, une seule source, pas de confidentialité particulière → testez un outil à fichiers type Gemini Notebook, dans le respect des limites de sources et de discussions de votre édition (Google Workspace).
- Quelques centaines de documents, 2 à 4 sources, droits d'accès à respecter → outil connecté, packagé ou sur mesure ; exigez connecteurs, OCR et citation à la page.
- Plusieurs milliers de documents, multi-métiers, exigences de conformité fortes → plateforme d'entreprise, le cas échéant avec un intégrateur (ordre de grandeur indicatif, à confronter à votre propre situation).
- Dans tous les cas → faites le test des 20 questions avant de signer, et prévoyez qui relira les réponses en production.
FAQ
Quelle est la meilleure IA pour les entreprises ? Il n'y a pas de gagnant universel : le bon outil dépend de vos sources, de vos volumes et de vos contraintes de confidentialité. Pour la recherche documentaire, la question utile n'est pas « quelle IA » mais « cite-t-elle sa source, respecte-t-elle mes droits d'accès, lit-elle mes scans ? ».
Quels sont les outils à comparer pour la recherche documentaire ? Trois familles cohabitent : les outils à fichiers (Gemini Notebook et Gemini Notebook Enterprise, dont les limites de sources et de requêtes sont documentées par Google), les plateformes d'enterprise search (Sinequa, Elasticsearch, Algolia, Google Cloud Search — technologies sur lesquelles l'intégrateur Coexya indique s'appuyer), et les développements sur mesure à base de frameworks documentés comme LlamaIndex. Comparez-les sur vos propres documents, pas sur des démos.
Faut-il développer son moteur en interne ? Selon LightOn, la question n'est pas de savoir si l'équipe peut produire une version fonctionnelle, mais si elle doit passer son temps à maintenir un pipeline de recherche complet plutôt qu'à travailler sur la valeur métier (LightOn) — un point de vue d'éditeur qui vend une alternative, donc à pondérer. Pour une PME sans informatique interne, c'est en pratique rarement le premier réflexe.
Où vont mes contrats confidentiels ? Ça dépend de l'offre, et c'est une question à poser par écrit. Exemples documentés : sur Gemini Notebook Enterprise, Google indique que les données sources sont stockées dans votre projet Google Cloud en zone multirégionale US ou EU et ne sont accessibles par aucun autre service Google Cloud ; côté Workspace, Google précise que les paramètres de région des données de l'organisation ne s'appliquent pas aux données mises en cache par le produit, et que, sur les éditions offrant la sécurité de niveau entreprise, les fichiers importés, discussions et réponses du modèle ne sont pas examinés par des réviseurs humains ni utilisés pour améliorer les modèles (Google Cloud, Google Workspace).
Combien de documents faut-il pour que ce soit rentable ? Le critère n'est pas le volume mais la fréquence des questions et le temps que coûte chaque recherche aujourd'hui. Faites le calcul vous-même, sur vos chiffres : à titre d'illustration arithmétique, cinq recherches par semaine de 45 minutes représentent 3 h 45 par semaine, soit de l'ordre de 170 heures sur 45 semaines travaillées (et environ 195 heures sur 52 semaines). Comparez ce montant au coût total de l'outil sur trois ans avant de décider.